
ระดับเนื้อหา: Overview / Implementation considerations
หลักการและการเลือกใช้
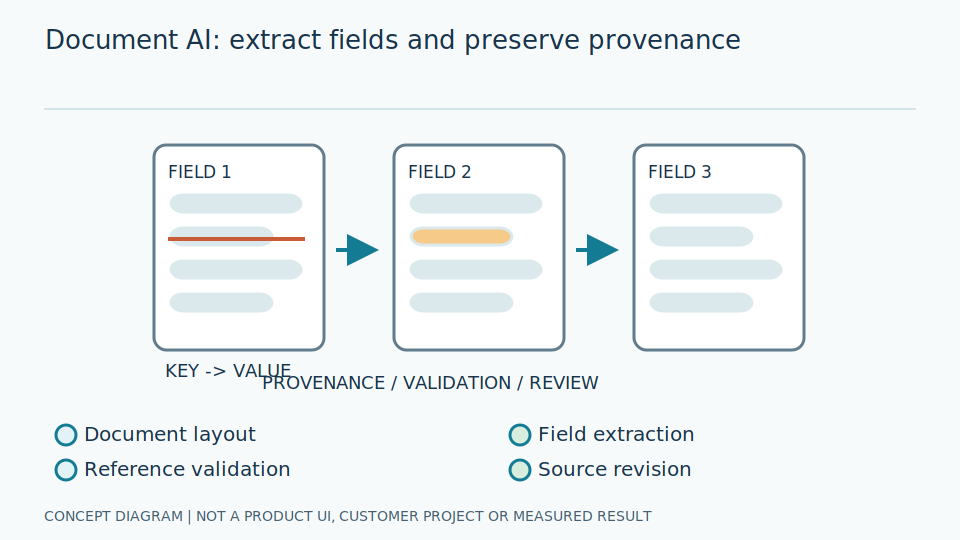
Key Information Extraction แปลงเอกสารเป็น field ที่มี schema โดยใช้ข้อความ ตำแหน่ง และบริบท OCR ที่ถูกต้องยังอาจจับคู่เลขกับหัวข้อผิด จึงต้องประเมินการสกัดข้อมูลปลายทางแยกจากการรู้จำตัวอักษร
การสกัดข้อมูลสำคัญหรือ KIE คือการเลือกข้อความไปอยู่ช่องที่มีความหมาย เช่น วันที่สอบเทียบ ไม่ใช่การคัดข้อความทั้งหน้า Field คือช่องข้อมูล ส่วน schema ระบุชื่อ ชนิด และเงื่อนไขของแต่ละช่อง เอกสารที่อ่านข้อความได้ครบอาจมีหลายวันที่หรือหลายหมายเลข จึงต้องตรวจความสัมพันธ์กับหัวข้อและตำแหน่ง ไม่เลือกตัวเลขแรกที่ตรงรูปแบบแล้วถือว่าเป็นคำตอบที่ถูก
วิศวกรกำหนดข้อความดิบ ค่าที่ปรับรูปแบบ และหลักฐานตำแหน่งแยกกัน เช่น แปลงวันที่ให้เป็นรูปแบบเดียวแต่ยังเก็บข้อความเดิม ต้องระบุ field ที่บังคับ ช่องที่ไม่พบ และกรณีหลายค่าขัดกันก่อนบันทึก การใช้บริบทช่วยจับคู่ได้แต่ไม่อนุญาตให้สร้างข้อมูลที่ไม่มีในเอกสาร พร้อมตรวจหมายเลขหน้าและการแปลงพิกัดเมื่อเอกสารถูกหมุนหรือย่อเพื่อให้ผู้ตรวจเห็นหลักฐานตรงจุด
เลื่อนแผนภาพซ้าย–ขวาเพื่อดูรายละเอียดครบทุกส่วน
ตัวอย่างในบริบทอุตสาหกรรม
ตัวอย่างเชิงออกแบบ: สกัดหมายเลขเครื่องมือ วันที่สอบเทียบ และหน่วยจากใบรายงาน โดยแยกวันที่ออกเอกสารออกจากวันที่สอบเทียบ และตรวจค่าที่ขัดกันก่อนบันทึก
สมมติใบรายงานมีวันที่จัดทำและวันที่ตรวจคนละวัน โปรแกรมอาจอ่านข้อความทั้งคู่ถูกแต่ใส่ผิดช่อง ผู้ตรวจควรเห็นหัวข้อกับข้อความที่เลือก ไม่ดูค่าที่ปรับรูปแบบแล้วอย่างเดียว หากเอกสารมีเครื่องมือหลายรายการ ต้องผูกหมายเลขกับผลในแถวเดียวกัน ไม่ใช้หมายเลขหัวกระดาษแทนทุกรายการ และกรณีช่องว่างควรเป็นไม่พบข้อมูล ไม่ใช่เติมจากเอกสารก่อนหน้า
วิศวกรทำตัวอย่างกำกับราย field พร้อมบริเวณหน้า แล้วทดสอบตารางข้ามหน้าและหัวข้อซ้ำ กฎตรวจความสอดคล้องช่วยส่งกรณีขัดกันให้คนยืนยัน แต่ไม่พิสูจน์ค่าที่ผ่านกฎถูก เช่น วันที่สมเหตุสมผลอาจยังเป็นคนละช่อง เมื่อบันทึกต้องแนบ schema version และที่มาหลักฐาน เพื่อให้ผู้ตรวจย้อนจากข้อมูลโครงสร้างไปยังข้อความจริงและเห็นว่าระบบไม่ได้อ้างเอกสารรับรองเกินสิ่งที่อ่าน
ขั้นตอนศึกษาและทดลอง
- 1 นิยาม schema field บังคับ รูปแบบ และค่าที่ไม่ทราบ
- 2 ทำ label ระดับ field พร้อมหลักฐานตำแหน่งบนหน้า
- 3 ตรวจ constraint และให้คนยืนยัน field สำคัญเมื่อ confidence ต่ำหรือขัดกฎ
วิธีประเมินและนิยามผล
รายงาน precision/recall หรือ exact match ต่อ field รวมผลถูกครบทั้งเอกสาร แยก normalized value จากข้อความดิบและทดสอบ template ใหม่
Normalized value คือค่าที่จัดรูปแบบให้เทียบกันได้ เช่น รูปวันที่ แต่การแปลงต้องไม่เปลี่ยนความหมายโดยเงียบ ควรระบุว่า exact match เทียบข้อความเดิมหรือค่าที่จัดแล้ว พร้อมช่องที่ไม่พบและช่องที่จับคู่ผิด การถูกหลายช่องไม่รับรองเอกสารครบหากหมายเลขเครื่องมือสำคัญผิด จึงต้องรายงานผลถูกครบตาม schema และผลของ field สำคัญแยกด้วย
วิศวกรกัน template หรือรูปแบบเอกสารที่ไม่ใช้พัฒนาเพื่อตรวจ layout ใหม่ พร้อมกรณีหลายหน้า ข้อความเอียง และตราทับ ตรวจหลักฐานหน้าและบริเวณที่ส่งออกกับค่าที่เก็บจริง หาก OCR ถูกแต่ field ผิดให้ตรวจการจับคู่ ไม่ฝึกตัวรู้จำใหม่ก่อนแยกสาเหตุ เอกสาร LayoutLM เป็นอ้างอิงวิธีรวมข้อความกับตำแหน่ง ไม่ใช่คำรับรองว่ารองรับเอกสารทุกชนิดหรือผลิตภัณฑ์ใช้โมเดลนี้แล้ว
ข้อจำกัดและกรณีผิดพลาด
layout drift ตารางข้ามหน้า และหัวข้อซ้ำทำให้จับคู่ผิด การเติมข้อมูลที่ไม่พบจากบริบทอาจสร้างข้อเท็จจริงเท็จ
Layout drift คือรูปแบบหน้าเปลี่ยนไปจากตัวอย่าง เช่น ตำแหน่งช่องหรือการแยกตารางต่างกัน การใช้ตำแหน่งตายตัวอาจง่ายแต่เปราะ ส่วนโมเดลบริบทเพิ่มความยืดหยุ่นแต่ยังเลือกผิดได้ ต้องมีช่องทางไม่ทราบหรือหลายค่าขัดกัน ไม่บังคับให้ทุกเอกสารครบโดยสร้างค่าตามความคาดหวัง และต้องไม่กล่าวว่าการอ่านข้อความในใบรับรองยืนยันความถูกต้องของการรับรองนั้นเอง
เอกสารอาจมีข้อมูลบุคคลและข้อมูลอุปกรณ์ที่ไม่อนุญาตส่งต่อ ต้องกำหนดการเข้าถึงและระยะเก็บทั้งภาพกับค่าที่สกัด การเพิ่ม human review เพิ่มภาระคนแต่ช่วยตรวจช่องสำคัญได้ ควรเลือกตามความเสี่ยงของการบันทึกผิด ไม่ใช้คะแนนโมเดลเพียงอย่างเดียวเป็นการอนุมัติทางกฎหมาย ตัวอย่างนี้เป็นกระบวนการสกัดที่เสนอเพื่อประเมิน ไม่ยืนยันความสามารถเอกสารปัจจุบันของผลิตภัณฑ์
รายการตรวจสอบก่อนนำไปใช้
- schema มี version หรือไม่
- เก็บหลักฐานข้อความและหน้าอ้างอิงหรือไม่
- ข้อมูลส่วนบุคคลมี retention ชัดหรือไม่