
ระดับเนื้อหา: Overview / Implementation considerations
หลักการและการเลือกใช้
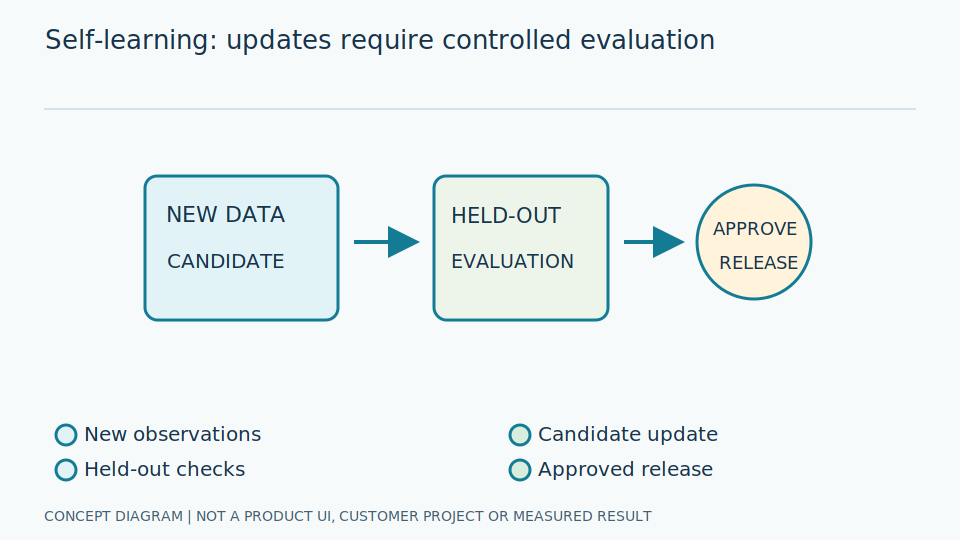
คำว่า self-learning อาจหมายถึง self-supervised learning, pseudo-labeling หรือ continual learning ซึ่งต่างกันทั้งหมด การเก็บ feedback ไม่เท่ากับการ retrain และการ retrain ไม่เท่ากับการอนุมัติ deployment
คำว่าเรียนรู้เองฟังเหมือนระบบปรับตัวได้ตลอดโดยไม่ต้องดูแล แต่ต้องระบุขั้นที่เกิดจริง Self-supervised สร้างงานเรียนจากโครงสร้างข้อมูล Pseudo-label ใช้ผลเดาเป็นคำตอบ และ continual learning เรียนต่อเพื่อรับงานใหม่ ทั้งหมดมีวิธีตรวจต่างกัน การเก็บภาพที่อ่านไม่ได้เป็นเพียงการรวบรวมหลักฐาน ไม่ได้ทำให้น้ำหนักโมเดลเปลี่ยนหรือผลดีขึ้นโดยอัตโนมัติ
วิศวกรแยกวงจร feedback การตรวจคำตอบ การฝึก candidate หรือรุ่นทดลอง และการอนุมัติใช้จริงออกจากกัน ข้อมูลใหม่ต้องมีเวอร์ชันและสิทธิ์ใช้ พร้อม test อิสระจากการคัดคำตอบของรุ่นเดิม การใช้ผลเดาโดยไม่ตรวจเสี่ยงย้ำข้อผิด ต้องมี gate หรือขั้นเงื่อนไขก่อนเปลี่ยนพฤติกรรม และรักษารุ่น production ที่ล็อกไว้ไม่ให้การเก็บข้อมูลเปลี่ยนผลระหว่างใช้งานอย่างไม่ตรวจรับ
เลื่อนแผนภาพซ้าย–ขวาเพื่อดูรายละเอียดครบทุกส่วน
ตัวอย่างในบริบทอุตสาหกรรม
ตัวอย่างเชิงออกแบบ: เก็บภาพ no-read ให้ผู้เชี่ยวชาญทำ label เพิ่ม แล้วฝึกโมเดล candidate แบบ offline โดยโมเดล production ไม่เปลี่ยนน้ำหนักเองระหว่างอ่านเกจ
สมมติภาพใหม่มาจากเกจชนิดหนึ่งที่รุ่นเดิมอ่านไม่ได้ ผู้ตรวจควรยืนยันว่าปลายเข็มและหน่วยเห็นจริงก่อนทำคำตอบ ไม่คัดผลเดาจากรุ่นเดิมมาแก้เพียงชื่อไฟล์ หากภาพมีแสงบังข้อมูล ควรระบุอ่านไม่ได้หรือแก้ต้นทางตามขั้นตอน ไม่ฝึกให้ระบบมั่นใจต่อภาพที่หลักฐานไม่ครบ และไม่นำภาพที่ใช้สรุปผลรุ่นเดิมไปฝึกแล้วอ้างว่าคะแนนทดสอบยังอิสระ
วิศวกรสร้างข้อมูลเวอร์ชันใหม่พร้อมคำตอบที่อนุมัติ แล้วฝึก offline ในเส้นทางที่ไม่เปลี่ยนรุ่นใช้จริง เปรียบกับรุ่นเดิมทั้งกลุ่มใหม่และกลุ่มที่เคยทำได้ ตรวจ calibration mapping กับ schema ที่สัมพันธ์กันก่อนปล่อย และทดสอบ rollback ทั้งชุด หากรุ่นใหม่ช่วยบางกลุ่มแต่เสียกลุ่มเดิม ต้องตัดสินตามเกณฑ์งาน ไม่ถือว่าข้อมูลล่าสุดสำคัญกว่าความเชื่อถือของงานเดิมโดยอัตโนมัติ
ขั้นตอนศึกษาและทดลอง
- 1 แยก feedback ที่ยืนยันแล้วจากผลเดาของโมเดล
- 2 สร้างข้อมูลเวอร์ชันใหม่และทดสอบ regression กับงานเดิม
- 3 ให้เจ้าของงานอนุมัติ candidate แล้ว rollout พร้อม rollback
วิธีประเมินและนิยามผล
วัดผลทั้งกลุ่มใหม่และกลุ่มเดิมเพื่อตรวจ catastrophic forgetting รวมอัตรา pseudo-label ผิดและการปนเปื้อน test จาก feedback
Catastrophic forgetting คือผลของงานเดิมลดลงหลังเรียนสิ่งใหม่ ต้องมีชุด regression หรือชุดตรวจพฤติกรรมเดิมควบคู่กับกลุ่มที่เพิ่ม ไม่วัดเฉพาะภาพใหม่ที่รุ่นทดลองฝึกมาแล้ว อัตราคำตอบเดาผิดควรตรวจด้วยตัวอย่างที่คนยืนยัน และรายงานจำนวนคำตอบที่ยังไม่ทราบ เพื่อไม่ให้การเพิ่มแฟ้มดูเหมือนเพิ่มข้อมูลมีคุณภาพทั้งที่ข้อผิดกำลังสะสม
วิศวกรตรวจ manifest กับประวัติ feedback ว่าไม่ปน test เข้าข้อมูลฝึกตามขอบเขตที่ประกาศ ล็อกเกณฑ์รับก่อนประเมิน candidate แล้วตรวจไฟล์ส่งออกและการย้อนกลับด้วยภาพอ้างอิง หากผลลดให้ทบทวนคำตอบและสัดส่วนข้อมูลก่อนกล่าวว่าต้องเรียนต่ออีก การใช้ registry หรือกรอบความเสี่ยงเป็นส่วนจัดกระบวนการ ไม่ใช่หลักฐานว่ามีการเรียนรู้ตนเองพร้อมใช้งานหรือรุ่นใหม่รับรองแล้ว
ข้อจำกัดและกรณีผิดพลาด
confirmation bias ทำให้ข้อผิดพลาดเดิมขยาย การเรียนออนไลน์โดยไร้ gate อาจเปลี่ยนพฤติกรรมที่ยังไม่เคยตรวจรับ
Confirmation bias ในวงจรนี้คือการเลือกคำตอบที่รุ่นเดิมเชื่อแล้วใช้สอนต่อ ทำให้สิ่งที่พลาดไม่ถูกแก้ ต้องสุ่มตรวจกรณีที่มั่นใจและไม่มั่นใจด้วย การเรียนออนไลน์เพิ่มความไวต่อข้อมูลล่าสุดแต่เสี่ยงพฤติกรรมเปลี่ยนระหว่างงาน ต้องมีผู้รับผิดชอบและเกณฑ์หยุด ไม่กล่าวว่าโมเดลปรับเองจึงไม่ต้องทดสอบหรือไม่มีความเสี่ยงจากคำตอบผิดและข้อมูลนอกขอบเขต
การเก็บข้อมูลต่อเนื่องเพิ่มประโยชน์ทบทวนแต่เพิ่มพื้นที่ สิทธิ์ และภาระทำป้าย ต้องกำหนดระยะเก็บและวัตถุประสงค์ก่อนใช้ฝึก ตัวอย่างนี้เสนอวงจรปรับปรุงแบบมีการอนุมัติ ไม่ยืนยันการเรียนออนไลน์หรือ retrain อัตโนมัติของผลิตภัณฑ์ปัจจุบัน และการอนุมัติรุ่นต้องพิจารณาทั้งข้อมูล โมเดล การตั้งค่า และผลปลายทาง ไม่ใช้คำว่า self-learning เป็นคำรับรองการพัฒนาคุณภาพเองทุกสภาพ
รายการตรวจสอบก่อนนำไปใช้
- นิยามการเรียนรู้ที่ใช้จริงหรือไม่
- ใครตรวจ label และอนุมัติ release
- ย้อนกลับทั้งโมเดลและข้อมูลได้หรือไม่