
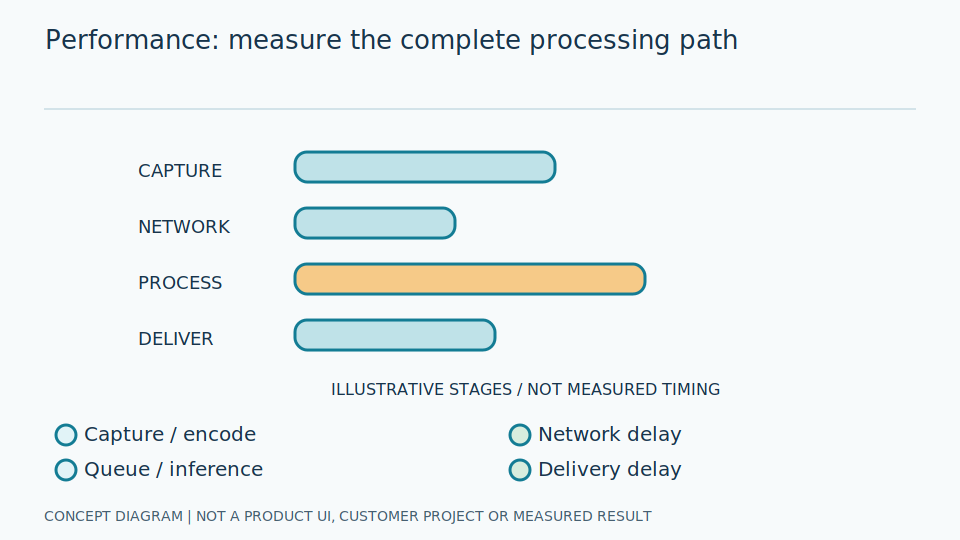
ระดับเนื้อหา: Overview / Implementation considerations
หลักการและการเลือกใช้
Latency คือเวลาต่อคำขอหรือเหตุการณ์ Throughput คือจำนวนงานต่อเวลา ส่วน availability คือสัดส่วนบริการที่ใช้ได้ตามนิยาม FPS ของโมเดลไม่เท่ากับจำนวนค่าที่อ่านถูกต่อวินาที p50 คือมัธยฐานและ p95 คือเปอร์เซ็นไทล์ที่ 95 ไม่ใช่ค่าสูงสุด
สำหรับผู้ใช้ คำถามสำคัญคือได้รับค่าที่ถูกและยังสดเมื่อจำเป็นหรือไม่ โปรแกรมที่เปิดอยู่ตลอดอาจอ่านภาพไม่ได้หรือส่งผลช้า จึงต้องแยกความพร้อมของบริการจากความพร้อมของข้อมูล FPS หมายถึงจำนวนเฟรมต่อวินาทีซึ่งอาจรวมภาพซ้ำหรือภาพอ่านไม่ได้ ไม่ควรใช้เป็นคำแทนผลวัดที่มีหน่วยครบและนำไปตัดสินได้จริง
วิศวกรกำหนดจุดเริ่มและจบของการจับเวลาให้ตรงกัน รวมช่วง warm-up หรือเตรียมระบบแยกจากช่วงใช้งานปกติ Tail คือส่วนเวลาที่ช้ากว่ากลุ่มใหญ่ซึ่งอาจสำคัญกับ deadline ต้องเก็บการกระจาย ไม่เพียงค่าเฉลี่ย Availability ต้องมีตัวหารและนิยามว่าใช้ได้อย่างไร พร้อมสถานะข้อมูลเก่าและข้อมูลขาด ไม่ใช้การตอบของพอร์ตหรือหน้าเว็บแทนการทำงานของเส้นทางอ่านทั้งหมด
เลื่อนแผนภาพซ้าย–ขวาเพื่อดูรายละเอียดครบทุกส่วน
ตัวอย่างในบริบทอุตสาหกรรม
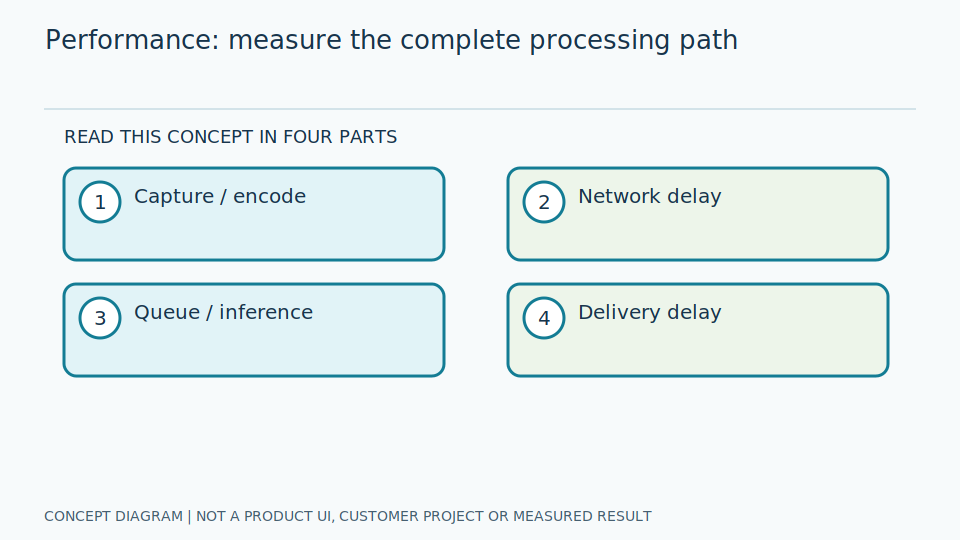
ตัวอย่างเชิงออกแบบ: งานเกจจับเวลาตั้งแต่ภาพถูกถ่ายจนค่าที่มีหน่วยถึงผู้รับ แล้วแยก decode, queue, inference และ network เพื่อหาส่วนที่ทำให้ผลช้า
สมมติส่วนโมเดลอ่านภาพเร็ว แต่คิวรับมีภาพสะสม ผลที่ถึงผู้ใช้จึงเก่า การปรับโมเดลให้เร็วอีกเล็กน้อยอาจไม่แก้สาเหตุ ต้องดูเวลารอคิวและอายุภาพจริง หากการรวมหลายภาพเป็น batch ช่วยทำงานมากขึ้น ก็ยังต้องตรวจภาพแรกในกลุ่มที่รอภาพอื่นด้วย ไม่รายงาน throughput ที่สูงขึ้นเหมือนเป็นการลดเวลารอของทุกคำขอ
วิศวกรใส่ตัวระบุภาพเดียวกันผ่านแต่ละขั้นเพื่อจับช่วงเวลาและตรวจผลที่คืนตรงกับภาพ ใช้ภาระจำลองตามจำนวนกล้องที่วางแผนโดยไม่รบกวนงานจริง ตรวจคำขอที่หมดเวลาและงานที่ยังค้างหลัง timeout ด้วย พร้อมกำหนดว่าจะยกเลิกหรือทิ้งผลช้าอย่างไร เพื่อไม่ให้การลองใหม่เพิ่มงานซ้ำและทำให้ภาระสูงกว่าที่ผู้ใช้ตั้งใจส่ง
ขั้นตอนศึกษาและทดลอง
- 1 นิยามจุดเริ่มจบ warm-up และภาระพร้อมกัน
- 2 เก็บ distribution ภายใต้ load ปกติและช่วงสูงสุดที่วางแผน
- 3 ทดสอบ timeout reconnect และ backlog พร้อมระบุเครื่องและเวอร์ชัน
วิธีประเมินและนิยามผล
รายงาน p50/p95 และ tail ที่เหมาะกับ deadline คู่ throughput อัตราผิดพลาดและจำนวนตัวอย่าง แยก service uptime จากสัดส่วนผลสดที่อ่านได้จริง
ระบุขนาดภาพ จำนวนงานพร้อมกัน รูปแบบตัวเลข และเครื่องที่ใช้พร้อมช่วงวัด เพื่อให้ผู้อ่านรู้ขอบเขตผล ควรนับคำขอทั้งหมดรวมที่ผิดพลาดหรือหมดเวลา ไม่เฉพาะคำขอสำเร็จซึ่งอาจทำให้เวลาที่รายงานดีเกินจริง แยกเวลาข้อมูลสดพร้อมใช้กับเวลาตอบข้อความสถานะ เพราะการตอบว่าอ่านไม่ได้เร็วไม่ได้หมายถึงได้ค่าที่งานต้องการเร็ว
วิศวกรตรวจการกระจายเวลารายขั้นกับทรัพยากร เช่น หน่วยความจำและความร้อน ระหว่างทำงานต่อเนื่องที่ควบคุมได้ หากค่า p95 เปลี่ยนมากตามช่วงวัดให้ดูคิวและเหตุขัดข้อง ไม่เลือกช่วงสั้นที่สวยที่สุด การวัดข้ามเครื่องต้องระบุการซิงก์นาฬิกาและข้อคลาด แนวทาง SRE เป็นอ้างอิงการสังเกตระบบ ไม่ใช่คำรับรอง SLA หรือความพร้อมของผลิตภัณฑ์
ข้อจำกัดและกรณีผิดพลาด
batching เพิ่ม throughput ได้แต่เพิ่มเวลารอ ค่าเฉลี่ยซ่อนเหตุช้าเป็นช่วง และผลข้ามเครื่องต้องควบคุมความคลาดของนาฬิกา
งานพร้อมกันอาจแย่งทรัพยากรและทำให้เวลาไม่เพิ่มเป็นสัดส่วนตรง การคูณผลจากหนึ่งกล้องเพื่อทำนายหลายกล้องจึงต้องตรวจสมมติฐาน ไม่รับรอง capacity จากตัวเลขเดียว การลดความละเอียดอาจช่วยเวลาแต่ทำให้เข็มหรือหน่วยหาย ต้องประเมินคุณภาพอ่านร่วมด้วย และไม่ตัดภาพยากจากงานทดสอบความเร็วหากเป็นภาพที่ต้องพบจริงในขอบเขตงาน
ตัวชี้วัดการปฏิบัติงานต้องมีนโยบายเมื่อเกินขอบเขต เช่น แจ้งข้อมูลเก่าหรือส่งตรวจ ไม่ใช้ค่าเฉลี่ยซ่อนผลช้าแต่สำคัญ การเก็บรายละเอียดช่วยวินิจฉัยแต่เพิ่มพื้นที่และต้องจัดการข้อมูลลับ ข้อสรุปต้องเป็นผลทดลองในเงื่อนไขที่บันทึก ไม่ขยายเป็นความเร็วหรือความประหยัดทั่วไป และไม่เรียกผลสังเกตหนึ่งครั้งว่าการรับรองเวลาตอบทุกสถานการณ์
รายการตรวจสอบก่อนนำไปใช้
- รวมเวลารอคิวหรือไม่
- ระบุ resolution batch precision หรือไม่
- ทดสอบต่อเนื่องจนเห็น thermal steady state หรือไม่